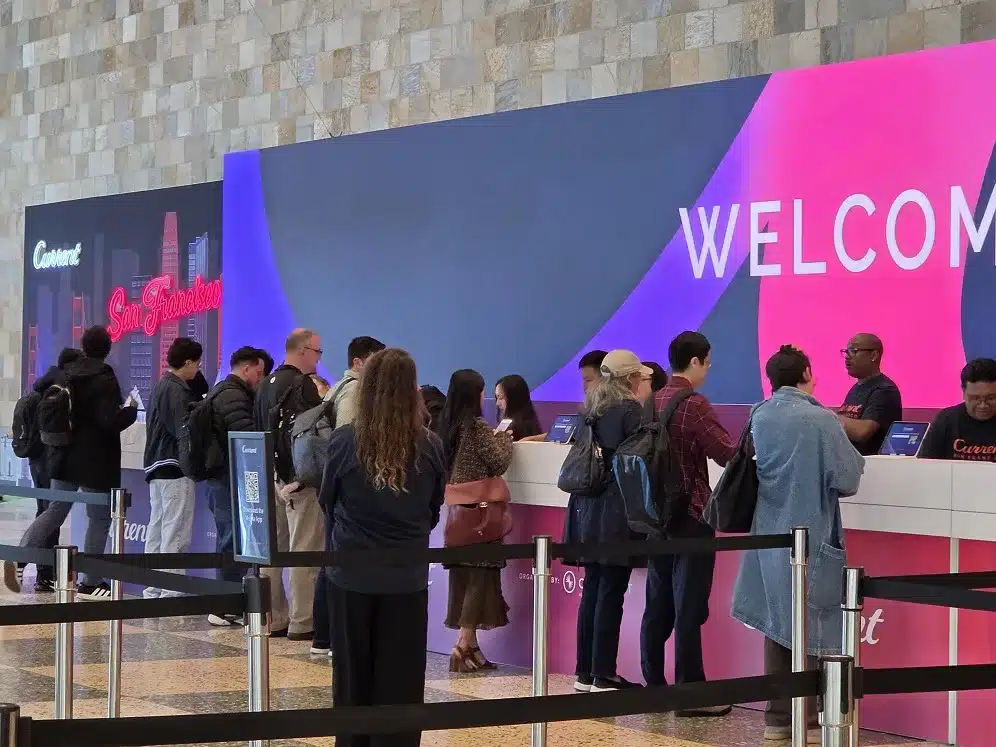
Confluent acaba de celebrar en San Francisco (EE.UU.) su conferencia Current 2026 donde la compañía recientemente adquirida por IBM ha proporcionado las capacidades clave de la arquitectura Streamhouse, concebida para dotar de contexto empresarial continuamente actualizado a los agentes de inteligencia artificial y aplicaciones críticas. Con la disponibilidad general de Lightning Tables, la compañía completa su plataforma unificada de cinco pilares: Transmitir, Conectar, Procesar, Gobernar y Consultar.
Durante el evento se pudo de manifiesto que la digitalización de las empresas ha alcanzado un punto de inflexión donde el volumen de información procesada ya no es el único factor que influye en el éxito o el fracaso de una organización, sino la inmediatez y coherencia con la que esos datos se ponen a disposición de la toma de decisiones autónoma.
Tal y como se describió el escenario tecnológico actual se está caracterizando por la acelerada adopción de sistemas agénticos que han puesto al descubierto las limitaciones estructurales de los modelos tradicionales de almacenamiento e integración de datos. En este escenario, los data lakes, almacenes de datos (warehouses) y lakehouses, diseñados históricamente para la generación de informes por lotes (batch) y el análisis retrospectivo, ya no son capaces de responder a las demandas de agentes digitales que requieren interpretar el estado del negocio al milisegundo. Y es a esta problemática a la que Confluent quiere dar solución con su arquitectura Streamhouse, una propuesta que busca resolver el desfase entre la creación del dato y su consumo operativo en tiempo real.
El fin de la latencia por lotes
De acuerdo a la exposición que realizó Shaun Clowes, General Manager, Confluent and Data de Confluent, “la raíz del problema arquitectónico en las grandes empresas se encuentra en la fragmentación de la información a través de sistemas heterogéneos que actualizan sus estados en momentos diferentes. En ese momento, cuando un agente de inteligencia artificial intenta ejecutar una tarea compleja, la discrepancia entre visiones contradictorias del mismo negocio provoca fallos de ejecución, decisiones erróneas o propagación de inconsistencias operativas”.
Para superar esta trampa de latencia, la arquitectura Streamhouse se sustenta sobre tres principios rectores irrenunciables: debe ser continuamente actual, de misión crítica y descentralizada. A diferencia de las iniciativas de consolidación masiva del pasado, no exige mover previamente todos los datos a un repositorio centralizado, sino que funciona como una capa operativa activa en tiempo real que coexiste de forma transparente con los almacenes y lakehouses existentes.
En el transcurso de la rueda de prensa posterior al evento y a la que asistió Byte TI, Clowes, subrayó la urgencia de este cambio de paradigma al analizar la evolución del software empresarial. El directivo destacó cómo los agentes inteligentes están alterando drásticamente los requerimientos de la infraestructura de datos afirmando que “la próxima era de la IA empresarial será ganada por los agentes que sepan qué está sucediendo en el negocio en el momento en que actúan”.
Para explicar la relación entre la información continua y los algoritmos agénticos, Clowes recurrió a una analogía sobre la refinación de recursos primarios: “Si la gente dice que los datos son el nuevo petróleo, lo que realmente quieren decir es que todavía deben ser refinados para ser útiles. No puedes simplemente quemar petróleo crudo y obtener algo útil de él”. En su opinión, la infraestructura de streaming es esa refinería que convierte el petróleo bruto en gasolina, es decir, en la verdadera ventaja competitiva.
En este marco, los agentes de IA no son simplemente consultas avanzadas, sino motores de alto rendimiento. El principal problema hasta ahora son los cuellos de botella que se producen precisamente por la intervención humana. Clowes fue categórico al describir la ineficiencia de los procesos manuales heredados frente a la automatización en tiempo real: “En muchos casos, la intervención humana es una supervisión inútil. Es un limitador de velocidad que hace que todo vaya más lento, por eso, al dotar a las empresas de una infraestructura continua, los problemas operativos pueden detectarse y resolverse de forma autónoma, liberando el talento humano para tareas de innovación estratégica”.
La plataforma de cinco pilares y la innovación de Lightning Tables
El pilar tecnológico que hace posible la arquitectura Streamhouse es la plataforma de streaming de datos, Data Streaming Platform o DSP, desarrollada sobre Apache Kafka y el motor Kora. La solución ha evolucionado hasta integrar cinco capacidades fundamentales unificadas: Transmitir (Stream), Conectar (Connect), Procesar (Process), Gobernar (Govern) y la recién incorporada capacidad de Consultar (Query).
El componente de transmisión captura y distribuye eventos empresariales con latencias inferiores al milisegundo en pruebas internas. El pilar de conexión facilita la ingesta y salida mediante más de 150 conectores totalmente gestionados hacia sistemas origen y destino. Por su parte, la capa de procesamiento emplea Apache Flink para enriquecer, transformar y combinar flujos continuos cerca de la fuente, mientras que el pilar de gobierno asegura la calidad, linaje, cifrado y cumplimiento normativo del dato a lo largo de todo su ciclo de vida mediante Stream Catalog.
La gran novedad anunciada en Current 2026 es el quinto pilar, Consultar (Query), concebido para poner los datos en streaming al servicio inmediato de aplicaciones, analítica y modelos de IA. Esta capacidad se despliega a través de tres interfaces especializadas: Confluent Tableflow, que alimenta lakehouses en formatos de tabla abiertos; el Real-Time Context Engine, que conecta con agentes mediante el Protocolo de Contexto de Modelos (MCP); y Lightning Tables.
Lightning Tables se presenta como una capa de servicio de solo lectura totalmente gestionada que materializa de forma duradera los eventos de Kafka en tablas consultables mediante SQL y APIs directas. Las pruebas internas de Confluent acreditan un tiempo de actualización de aproximadamente 100 milisegundos desde la creación de la información, con latencias de consulta situadas entre 10 y 100 milisegundos y un rendimiento superior a 1.000 consultas por segundo. Gracias a ello se simplifica la arquitectura TI al eliminar la necesidad de construir canalizaciones ETL complejas, bases de datos intermedias o capas de caché dedicadas. Además, actúa como un almacén de características en tiempo real para personalización y aprendizaje automático.
Durante su ponencia principal en el evento, Shaun Clowes recalcó que Streamhouse no es un producto cerrado ni una invención aislada, sino un patrón arquitectónico emergente en toda la industria:
La disponibilidad de Lightning Tables marca un cambio en el que la consulta analítica y el evento operativo convergen definitivamente. Como resumió Clowes durante la presentación, “con Lightning Tables, nuestra Plataforma de Streaming de Datos brinda a cada agente y aplicación una visión en vivo y gobernada del negocio. Esto significa que las empresas pueden actuar sobre las señales de fraude más rápido, atender a los clientes en el momento y ejecutar las operaciones basándose en lo que es verdad hoy frente a lo que era verdad ayer».
Integración en IBM
La presentación de Streamhouse adquiere una dimensión corporativa aún más relevante tras la integración de Confluent en la estructura global de IBM. En el esquema estratégico de la multinacional, Confluent se ha posicionado en el centro neurálgico de la estrategia de datos de IBM, combinando la transmisión en tiempo real con la suite de integración, gobierno e IA de IBM. Esta sinergia no responde a un empaquetado comercial artificial, sino a la complementariedad natural entre tecnologías como Apache Kafka, Apache Flink, Red Hat, HashiCorp y watsonx.
Frente a las dudas de la industria sobre si la pertenencia a un gigante tecnológico podría restringir la interoperabilidad con otros proveedores, Shaun Clowes fue enfático al ratificar la vocación abierta y no restrictiva de la plataforma. Clowes conceptualizó el papel de Confluent dentro de los ecosistemas empresariales como un elemento opuesto al bloqueo de datos (vendor lock-in). “Tenemos lo que llamamos “antigravedad de datos”. Somos lo contrario de un lugar donde pones tus datos y nunca salen. Nuestro trabajo es entregar los datos al lugar en el que sea posible. Literalmente distribuimos datos; somos un intercambiador de información en cierto sentido”.
Esta visión de intercambio continuo refuerza la posición de Confluent al actuar como una autopista de datos que elimina la duplicación inútil y la integración fragmentada. Clowes detalló cómo esta arquitectura aligera la carga sobre la infraestructura corporativa afirmando que “Confluent está en el centro de la estrategia de datos de IBM La misión de Confluent siempre ha sido permitir que las personas obtengan valor de sus datos sin tener que reprocesarlos una y otra vez. Nos comportamos como una superautopista de información entre todos estos sistemas diferentes, eliminando la necesidad de duplicados, la integración manual de aplicaciones y los silos”.
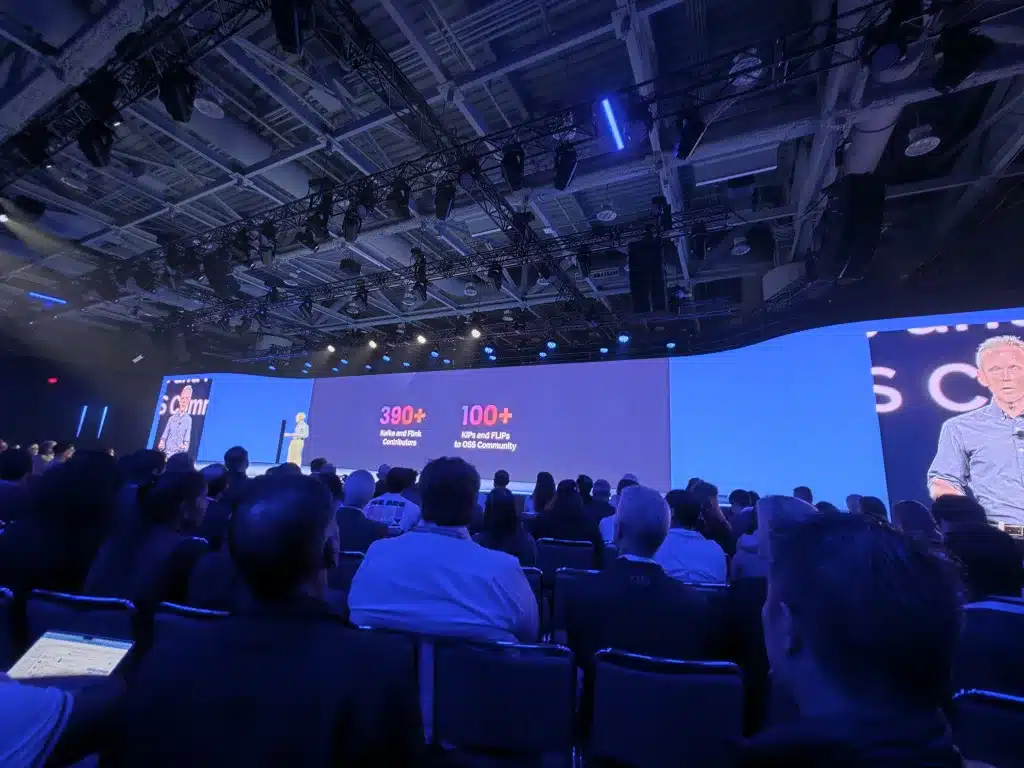
Asimismo, el compromiso con el desarrollo de código abierto sigue siendo un pilar innegociable. Confluent e IBM se mantienen como los principales contribuidores de proyectos comunitarios emblemáticos como Apache Kafka y Apache Flink. Clowes enfatizó que “el código abierto no es el enemigo; ayuda a movilizar el dato, y la única forma de abordar un problema a escala global es contar con proyectos de código abierto de gran éxito que se utilicen en todo el ecosistema”.